Cómo demostrar que un PDF no se ha alterado: hashes y huellas
Daan van Tongeren
PDFengine Team
Demostrar que dos PDF son idénticos, o que uno no se ha alterado, se reduce a una sola cosa: un hash criptográfico. Un hash es una huella digital breve de un PDF, calculada a partir del contenido del archivo. Si dos archivos producen el mismo hash, son iguales byte a byte. Si cambia un solo carácter, el hash cambia por completo. Eso te da una prueba matemática, no un subjetivo «a mí me parece igual».
Hay una trampa que desconcierta incluso a abogados y personal de TI con experiencia. Dos PDF que se ven idénticos y se leen igual pueden devolver hashes distintos. Eso no significa que se haya manipulado el documento. A continuación explico por qué ocurre, qué hash resuelve de verdad la cuestión y cómo obtener un resultado defendible sin abrir nunca un terminal.
Puntos clave
Un hash criptográfico demuestra que dos archivos son idénticos byte a byte; si cambias un solo carácter, la huella cambia por completo.
Dos PDF visualmente idénticos suelen producir hashes SHA-256 distintos porque al guardar un PDF se reescribe un campo oculto
/ID. Eso es normal, no es manipulación.SHA-256 es un hash seguro estandarizado a nivel federal (NIST FIPS 180-4); el antiguo SHA-1 tiene colisiones demostradas y no debe usarse como prueba.
Cuatro hashes independientes (bytes, texto, aspecto visual, metadatos) pueden demostrar que el contenido siguió siendo idéntico aunque cambiaran los metadatos. Un único hash de bytes no puede.
Un hash prueba que algo es igual, no quién cambió un archivo ni cuándo. Para eso, combínalo con un sello de tiempo de confianza o una firma.
¿Qué significa realmente demostrar que dos PDF son idénticos?
Que dos archivos sean idénticos significa que su contenido coincide exactamente, y un hash criptográfico es la forma de demostrarlo. SHA-256 es una función hash segura estandarizada a nivel federal que produce una huella de 256 bits (NIST FIPS 180-4). Aplícala a un archivo y obtendrás una cadena de 64 caracteres. Aplícala de nuevo a una copia idéntica y obtendrás la misma cadena, siempre.
El valor está en la sensibilidad. Cambia un bit, una coma o un píxel, y el resultado se transforma por completo. No hay coincidencias parciales. Por eso los tribunales y los reguladores se apoyan en el hash para demostrar que una prueba electrónica no se ha alterado desde que se recopiló. El razonamiento sigue el marco de autenticación de las Federal Rules of Evidence de EE. UU., según el cual una parte debe demostrar que un elemento es lo que afirma ser (American Bar Association, 2017).
En términos prácticos, un hash SHA-256 ocupa un espacio de 2^256 direcciones, por lo que una huella coincidente se considera una prueba prácticamente concluyente de que dos archivos son idénticos byte a byte; reguladores como la SEC exigen que los registros se conserven en un formato no reescribible precisamente para poder demostrar su integridad más adelante (SEC Rule 17a-4).
¿Por qué dos PDF idénticos tienen hashes distintos?
Porque un PDF se reescribe a sí mismo cada vez que lo guardas, aunque no cambies nada visible. Es el punto peor entendido de la informática forense documental, y lleva a la gente constantemente a conclusiones equivocadas. Se topan con él los desarrolladores y los notarios, y los foros están llenos de esta confusión. Un artículo de la base de conocimiento de iText se titula literalmente «Why are PDF files different even if the content is the same?».
El culpable está en el trailer del PDF: una matriz /ID. La especificación pide a los programas que escriben PDF que guarden ahí un identificador único, y la mayoría del software PDF lo regenera en cada guardado. Exporta desde Vista Previa, duplica el archivo, a veces incluso imprime a PDF, y ese valor oculto cambia. Las páginas se ven igual. El texto se lee igual. Pero los bytes en bruto difieren, así que el hash del PDF cambia aunque no cambie nada visible.
Aquí es donde el ingenuo consejo de «simplemente compara el hash» se vuelve peligroso en un contexto jurídico. Un jurista compara dos hashes de bytes, ve que no coinciden y concluye erróneamente que el documento se manipuló. En realidad, un guardado rutinario cambió el envoltorio, no el fondo. Un desarrollador documentó esta misma trampa mientras depuraba hashes de PDF (Phoenix Effect), y los peritos forenses la debaten bajo títulos como «Same content different hash values».
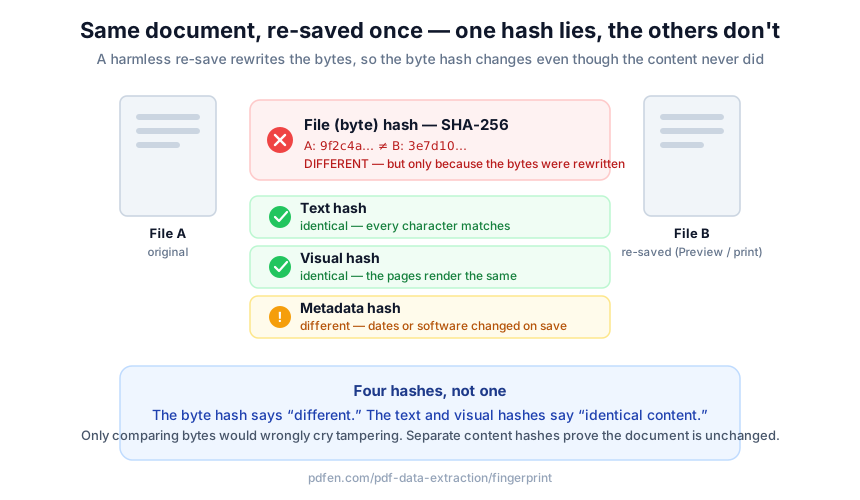 Izquierda: un guardado inocuo cambia los bytes en bruto, así que el hash de bytes SHA-256 difiere (cruz roja). Derecha: la página renderizada y la capa de texto no cambian, así que el hash de contenido y el visual siguen coincidiendo (marca verde).
Entonces, ¿cómo distingues una edición real de un guardado cosmético? Dejas de depender de un único hash de bytes.
¿Cómo compruebas si dos archivos PDF son iguales sin falsas alarmas?
Calculas el hash de cada capa por separado, no solo el de los bytes en bruto. Un hash de archivo responde a «¿son exactamente los mismos bytes?». Un hash de contenido responde a la pregunta que normalmente te importa: «¿es el mismo documento?». Cuando construí la herramienta de huellas digitales en PDFengine, este enfoque por capas surgió directamente de ver cómo la gente interpretaba como fraude las discrepancias de los hashes de bytes.
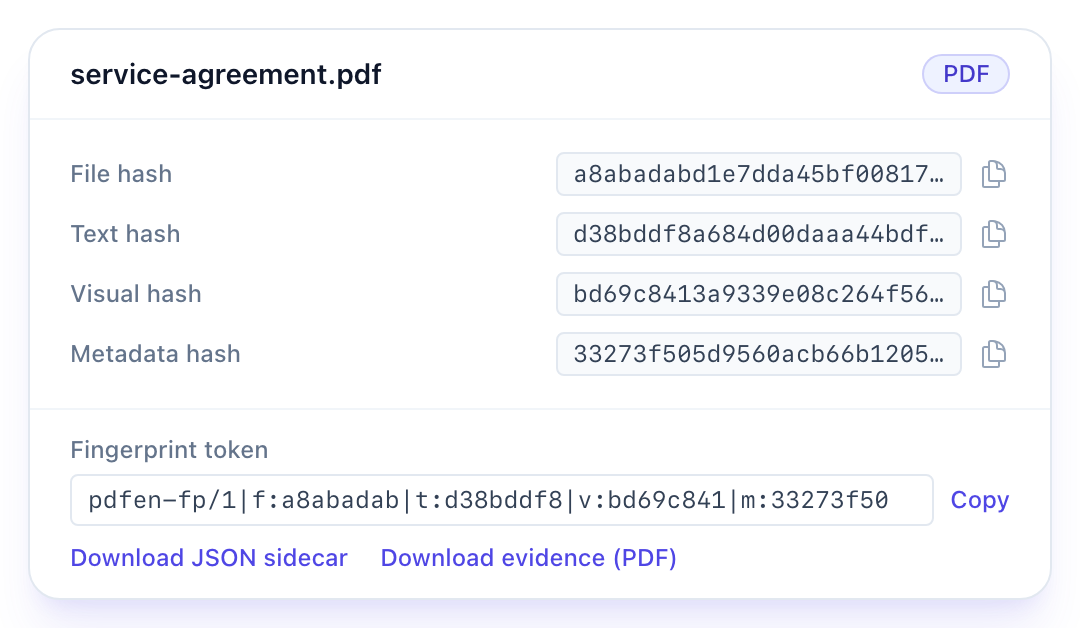
La herramienta de huellas digitales de PDFengine calcula cuatro hashes independientes de un mismo archivo:
Hash de archivo — SHA-256 de los bytes en bruto. Detecta cualquier cambio, incluida la reescritura de
/IDrewrite.Hash de texto — la capa de texto normalizada, sin metadatos. Es tu huella del contenido.
Hash visual — las páginas renderizadas normalizadas, de modo que también se cubre un documento escaneado o basado en imágenes.
Hash de metadatos — el conjunto de metadatos normalizado, aislado por sí solo.
Como las capas son independientes, puedes demostrar algo que una simple suma de verificación nunca podría. Supón que eliminas los metadatos personales de un contrato antes de compartirlo, con una herramienta de eliminación de metadatos. Cambian el hash de archivo y el hash de metadatos, justo como se espera. Pero el hash de texto y el hash visual siguen idénticos. Esa combinación es la prueba: el contenido no se tocó, solo se movieron los metadatos. Un único hash de bytes diría simplemente «distinto» y no te contaría nada de lo que realmente difería.
En resumen: PDFengine calcula cuatro hashes por capas por archivo, de modo que su veredicto puede distinguir «mismo contenido, metadatos distintos» de «el contenido difiere», una distinción que ninguna cadena SHA-256 por sí sola puede expresar.
¿Cómo demuestras en la práctica que un PDF no se ha alterado?
Tomas la huella del archivo en un momento de confianza, guardas esa huella y la vuelves a comprobar más tarde. El flujo está pensado para personas que nunca tocarán una línea de comandos, que son la mayoría de los abogados, notarios y responsables de cumplimiento. Subes el PDF, el archivo de Office, la imagen o el correo, y obtienes un token de huella más un archivo JSON complementario descargable. Ese token es tu referencia.
Más adelante pegas el token o el JSON en «Comparar con una huella guardada», y la herramienta te dice con precisión qué ha cambiado. Los veredictos están en lenguaje claro, no en un muro de hexadecimal:
Idéntico — coinciden los bytes, el contenido y los metadatos.
Mismo contenido y metadatos; solo difieren los bytes — el caso inocuo de un nuevo guardado.
Mismo contenido, metadatos distintos — por ejemplo, metadatos eliminados o editados.
El contenido difiere — un cambio real en el documento.
En el caso del correo, la herramienta calcula huellas por nodo, es decir, cada archivo adjunto tiene su propio conjunto de hashes. Eso importa cuando una disputa depende de un PDF enterrado dentro de un mensaje reenviado. Si necesitas comparar dos archivos directamente en lugar de con una referencia guardada, la herramienta de comparación de archivos muestra la misma matriz de igualdad lado a lado.
Un límite que conviene dejar claro. Demostrar que un correo se envió es una cuestión distinta de demostrar que un archivo no se ha alterado, y se apoya en señales de transmisión como SPF y DKIM en lugar de en el hash de archivos. Lo trato por separado en cómo demostrar que se envió un correo. Esta entrada se centra en la identidad de archivos y PDF.
¿Por qué SHA-256 y no MD5 o SHA-1?
Porque los algoritmos antiguos están rotos para uso probatorio, y SHA-256 es el estándar federal actual (proyecto de funciones hash del NIST). No es una precaución teórica. Las colisiones de SHA-1 están demostradas, no solo previstas. El proyecto de código abierto sha1collider genera dos PDF distintos que comparten el mismo hash SHA-1 (nneonneo en GitHub).
Piensa en lo que eso significa en una sala de tribunal. Si tu prueba de integridad se basa en SHA-1, una parte contraria puede alegar que un hash coincidente ya no garantiza un archivo coincidente, porque es posible provocar una colisión. Ese argumento no funciona contra SHA-256. Su resultado vive en un espacio de 2^256 y no se ha producido ninguna colisión práctica. Para todo lo que quizá tengas que defender, usa SHA-256 y no mires atrás.
¿Un algoritmo moderno no es excesivo para una comprobación interna de documentos? No realmente. El coste de calcular SHA-256 es trivial, y estandarizar ya en él significa que nunca tendrás que recalcular los hashes de un archivo cuando el algoritmo más débil acabe suspendiendo una auditoría.
¿No puede Adobe Acrobat decirme simplemente si dos PDF son idénticos?
No directamente, y esto sorprende a la gente. Acrobat no tiene un botón sencillo de hash para saber si dos archivos son idénticos byte a byte. Su mecanismo de integridad son las firmas digitales basadas en certificados: calcula el hash del documento, cifra el resumen con el certificado del firmante y vuelve a calcular el hash al abrirlo para detectar cambios hechos después de firmar (estándares de firma digital de Adobe). Es realmente sólido, pero solo si el documento se firmó con antelación. «Comparar archivos» de Acrobat es una comparación visual y de texto, que responde a «qué ha cambiado», no a «es el archivo criptográficamente idéntico».
Pregunta que tienes | Adobe Acrobat | Huella de PDFengine |
|---|---|---|
¿Son estos dos archivos idénticos byte a byte? | Sin comprobación de hash específica | Hash de archivo (SHA-256) |
¿Cambió el contenido, ignorando un nuevo guardado? | Diferencias de «Comparar archivos» (visual) | Hash de texto + visual |
¿Prueba sin firmar el archivo con antelación? | No; requiere una firma digital previa | Sí; toma la huella de cualquier archivo existente |
¿Funciona con correo y archivos adjuntos? | No | Sí, por nodo |
¿Se puede usar sin conocimientos técnicos? | En parte | Sí, veredictos en lenguaje claro |
Acrobat y PDFengine resuelven problemas que se solapan pero son distintos. Si firmaste el documento de antemano, la firma de Acrobat es excelente. Si hoy te entregan un archivo y te preguntan «¿es el mismo que presentamos el año pasado?», necesitas una huella, no una firma. La propia página de precios de Adobe cubre la parte de la suscripción si quieres el flujo de firma.
Preguntas frecuentes
¿Por qué dos PDF con el mismo contenido tienen valores hash distintos?
Porque al guardar un PDF se reescriben bytes ocultos, sobre todo el valor /ID del trailer del archivo, aunque no cambie nada visible. Dos PDF con contenido idéntico devuelven entonces hashes SHA-256 distintos (iText). Es un comportamiento normal, no una manipulación. Un hash de texto o visual ignora ese envoltorio y confirma que el contenido es el mismo.
¿Es un hash prueba de que un documento no se manipuló?
Un hash coincidente demuestra que dos archivos son idénticos byte a byte, lo que es una prueba sólida de igualdad e integridad. Pero un hash por sí solo no demuestra quién cambió un archivo ni cuándo. Según el marco de las Federal Rules of Evidence de EE. UU., los hashes respaldan la autenticación (Duke Judicature), sobre todo cuando se combinan con un sello de tiempo de confianza o una firma. Respalda la admisibilidad; no la garantiza.
¿Cómo obtengo el SHA-256 de un PDF sin usar la línea de comandos?
Sube el archivo a la herramienta de huellas digitales de PDFengine y obtendrás el hash de archivo SHA-256 más tres hashes basados en el contenido, sin terminal. Esto importa para usuarios no técnicos; los hilos del foro de Adobe muestran a gente que quiere verificar que una descarga no se ha modificado sin ninguna CLI (Adobe Community). También obtienes un token que puedes guardar y un PDF de pruebas descargable.
¿Puedo demostrar que eliminar los metadatos no cambió el contenido real?
Sí, y aquí es donde los hashes separados se ganan su lugar. Tras eliminar los metadatos, cambian el hash de archivo y el de metadatos, pero el hash de texto y el visual siguen idénticos. Esa combinación demuestra que el contenido no se tocó. Un único hash de bytes solo puede decir «distinto», lo que sugeriría erróneamente que se editó el documento en sí cuando solo se movieron los metadatos.
¿Debo usar SHA-1 o MD5 si es lo que usa nuestro sistema antiguo?
No para nada que quizá tengas que defender. Las colisiones de SHA-1 están demostradas: el proyecto sha1collider construye dos PDF distintos con el mismo hash SHA-1 (GitHub). SHA-256 es el estándar federal (NIST FIPS 180-4) y no tiene colisiones prácticas. Conserva el hash antiguo para búsquedas heredadas si debes, pero basa las pruebas en SHA-256.
Cómo conseguir un resultado defendible
Demostrar que un PDF es idéntico, o que no se alteró, es más matizado que «comparar el hash». El hash de bytes dice la verdad, pero no toda la verdad, porque un guardado normal cambia los bytes sin tocar el documento. Separar los hashes de archivo, texto, visual y metadatos es lo que convierte una discrepancia confusa en un veredicto claro.
Si necesitas esa claridad sin terminal, toma la huella de tu archivo con la herramienta de huellas digitales de PDFengine, guarda el token y vuelve a comprobarlo cuando surja una duda. Para comparar dos archivos entre sí, usa la comparación de archivos. Y recuerda el límite sincero: un hash demuestra igualdad, no autoría ni momento. Para eso, combínalo con un sello de tiempo de confianza o una firma. Usada así, una huella te da pruebas en las que puedes apoyarte.
Por Daan van Tongeren, fundador de PDFengine.
Artículos relacionados
Cómo organizar tus PDF: 5 herramientas que debes conocer
Con cualquier archivo digital surge algún contratiempo: páginas giradas, archivos bloqueados, etc. P...
Convertir archivos por correo: una forma más rápida de pasar a PDF
Convertir, unir o comprimir tus archivos es ahora aún más eficiente con la conversión por correo. Ad...