Extrae el texto de documentos PDF
Convierte tus archivos PDF a texto plano (.txt). Ideal para extraer contenido, analizar datos y eliminar el formato.
Más información sobre esta conversión
Desde conversiones sencillas hasta automatizaciones más complejas con workflows, PDFengine ofrece herramientas de nivel profesional para cada tarea con PDF.
Extracción de texto limpia
Extrae solo el contenido de texto de los PDF, sin formato, imágenes ni diseño. Obtén texto plano que puedes usar en cualquier editor de texto o aplicación. Los archivos de texto se guardan con codificación UTF-8, lo que garantiza la compatibilidad con todos los idiomas y caracteres especiales en cualquier plataforma.
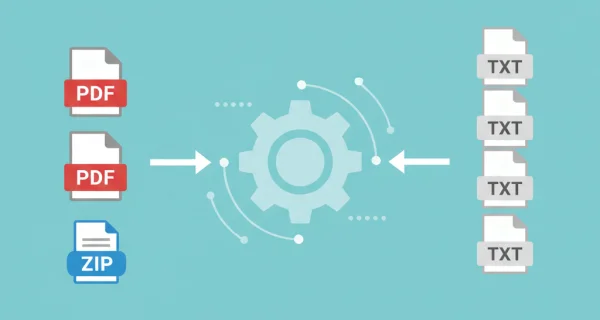
Procesamiento por lotes
Convierte varios archivos PDF a la vez o sube archivos ZIP con varios documentos para extraer el texto por lotes de forma eficiente.

Aún más eficiencia con los workflows de PDFengine
Lleva la gestión de documentos al siguiente nivel combinando y encadenando herramientas de conversión, optimización y organización de PDF. Con workflows totalmente personalizables, las tareas complejas con PDF se resuelven en segundos.
Por qué elegirnos para convertir tus archivos
Conversión ultrarrápida
Nuestro avanzado motor de conversión procesa tus archivos en segundos, no en minutos. Sube, convierte y descarga, todo en un momento.
Pensado para empresas
Archiva y convierte correos electrónicos, AutoCAD, Visio y archivos de Office en un único workflow ágil. Ideal para empresas con procesos documentales recurrentes.
Calidad perfecta siempre
Nuestros algoritmos inteligentes conservan el formato, las fuentes, las imágenes y la maquetación. Lo que ves es lo que obtienes, sin pérdida de calidad.
Cómo funciona
Procesa tus documentos de forma fácil y rápida en tres pasos
Sube tus archivos PDF
Selecciona tus archivos PDF o sube un archivo ZIP con varios documentos PDF de los que quieras extraer el texto.
Extrae el texto
Nuestro sistema extrae todo el texto legible de tus PDF y elimina el formato y las estructuras de diseño.
Descarga los archivos de texto
Obtén tus archivos de texto plano listos para analizar o procesar. Si son varios, se empaquetan en un archivo ZIP.
Preguntas frecuentes
¿El texto conservará los saltos de línea y los párrafos?
El conversor extrae el texto tal como aparece en el PDF e intenta conservar los saltos de párrafo. Sin embargo, los diseños complejos pueden requerir algo de limpieza manual del archivo de texto resultante.
¿Puedo convertir PDF escaneados a texto?
Los PDF escaneados contienen imágenes de texto, no texto real. Para convertir esas imágenes en texto editable hace falta OCR (reconocimiento óptico de caracteres). Nuestro conversor estándar funciona mejor con PDF basados en texto. Puedes activar el OCR para convertir mejor los PDF basados en imágenes.
¿Qué ocurre con las imágenes y las tablas?
Las imágenes se omiten durante la extracción de texto. El contenido de las tablas se extrae como texto plano, aunque la estructura tabular puede perderse. Para conservar la estructura de las tablas, considera la conversión de PDF a Excel.
¿Puedo convertir varios PDF a la vez?
Sí, puedes subir varios archivos PDF o un archivo ZIP con hasta 50 PDF para extraer el texto por lotes.
¿Listo para extraer el texto de tus PDF?
Convierte tus documentos PDF en archivos de texto plano para editarlos, analizarlos y procesar datos con facilidad.
Otras conversiones
Convierte entre PDF y distintos formatos de documento. Extrae los datos en el formato que mejor se adapte a tus necesidades.
PDF a Word
Convierte documentos PDF al formato Word
PDF a Excel
Convierte documentos PDF al formato Excel
PDF a texto
Extrae el contenido de texto de documentos PDF
OCR de PDF
Añade una capa de texto con capacidad de búsqueda a documentos PDF escaneados