Beweisen, dass zwei PDFs identisch sind oder ein PDF unverändert ist
Daan van Tongeren
PDFengine Team
Um zu beweisen, dass zwei PDFs identisch sind oder dass eines nicht verändert wurde, braucht es nur eines: einen kryptografischen Hash. Ein Hash ist ein kurzer PDF-Fingerabdruck, der aus dem Inhalt der Datei berechnet wird. Liefern zwei Dateien denselben Hash, sind sie bis aufs Byte gleich. Hat sich auch nur ein einziges Zeichen geändert, ändert sich der Hash vollständig. Das liefert dir einen mathematischen Beleg statt eines subjektiven „sieht für mich gleich aus“.
Dabei gibt es einen Haken, über den selbst erfahrene Juristen und IT-Mitarbeitende stolpern: Zwei PDFs, die identisch aussehen und sich identisch lesen, können trotzdem unterschiedliche Hashes liefern. Das bedeutet nicht, dass das Dokument manipuliert wurde. Im Folgenden erkläre ich, warum das passiert, welcher Hash die Frage tatsächlich klärt und wie du ein belastbares Ergebnis bekommst, ohne je ein Terminal zu öffnen.
Das Wichtigste in Kürze
Ein kryptografischer Hash belegt, dass zwei Dateien Byte für Byte identisch sind; ändert sich ein Zeichen, ändert sich der Fingerabdruck vollständig.
Zwei optisch identische PDFs liefern oft unterschiedliche SHA-256-Hashes, weil jedes Speichern ein verborgenes
/ID-Feld neu schreibt. Das ist normal und keine Manipulation.SHA-256 ist eine vom US-Bund standardisierte sichere Hashfunktion (NIST FIPS 180-4); das ältere SHA-1 hat nachweislich Kollisionen und sollte als Beweis nicht verwendet werden.
Vier getrennte Hashes (Bytes, Text, Optik, Metadaten) können belegen, dass der Inhalt identisch geblieben ist, auch wenn sich die Metadaten geändert haben. Ein einzelner Byte-Hash kann das nicht.
Ein Hash belegt Gleichheit, nicht, wer eine Datei wann geändert hat. Kombiniere ihn dafür mit einem vertrauenswürdigen Zeitstempel oder einer Signatur.
Was bedeutet es eigentlich, zu beweisen, dass zwei PDFs identisch sind?
Identität zwischen zwei Dateien bedeutet, dass ihr Inhalt exakt übereinstimmt, und ein kryptografischer Hash ist das Mittel, das zu belegen. SHA-256 ist eine vom US-Bund standardisierte sichere Hashfunktion, die einen 256-Bit-Fingerabdruck erzeugt (NIST FIPS 180-4). Wendest du sie auf eine Datei an, erhältst du eine Zeichenkette mit 64 Zeichen. Wendest du sie auf eine identische Kopie an, erhältst du jedes Mal dieselbe Zeichenkette.
Der Wert liegt in der Empfindlichkeit. Kippst du ein Bit, änderst du ein Komma, bearbeitest du ein Pixel, wird die Ausgabe bis zur Unkenntlichkeit verändert. Es gibt keine teilweise Übereinstimmung. Deshalb stützen sich Gerichte und Aufsichtsbehörden auf Hashing, um zu zeigen, dass elektronische Beweise seit der Sicherung nicht verändert wurden. Die Argumentation folgt dem Authentifizierungsrahmen der US Federal Rules of Evidence, nach dem eine Partei zeigen muss, dass ein Beweisstück das ist, was es zu sein vorgibt (American Bar Association, 2017).
Praktisch gesehen belegt ein SHA-256-Hash einen Adressraum von 2^256, sodass ein übereinstimmender Fingerabdruck als praktisch schlüssiger Beleg dafür gilt, dass zwei Dateien Byte für Byte gleich sind; Aufsichtsbehörden wie die SEC verlangen, dass Aufzeichnungen in nicht überschreibbarer Form aufbewahrt werden, eben damit sich die Integrität später nachweisen lässt (SEC Rule 17a-4).
Warum haben zwei identische PDFs unterschiedliche Hashes?
Weil sich ein PDF bei jedem Speichern selbst neu schreibt, selbst wenn du nichts Sichtbares änderst. Das ist der am häufigsten missverstandene Punkt der Dokumentenforensik, und er führt immer wieder zu falschen Schlüssen. Entwickler stolpern darüber, Notare stolpern darüber, und Forenthreads sind voll von dieser Verwirrung. Ein Wissensdatenbank-Artikel von iText trägt buchstäblich den Titel „Why are PDF files different even if the content is the same?“.
Der Übeltäter sitzt im PDF-Trailer: einem /ID-Array. Die Spezifikation verlangt, dass dort eine eindeutige Kennung gespeichert wird, und die meiste PDF-Software erzeugt sie bei jedem Speichern neu. Exportierst du aus der Vorschau, duplizierst du die Datei oder druckst du manchmal sogar in ein PDF, verschiebt sich dieser verborgene Wert. Die Seiten sehen gleich aus. Der Text liest sich gleich. Aber die Rohbytes unterscheiden sich, also ändert sich der PDF-Hash, obwohl sich nichts Sichtbares geändert hat.
Hier wird der naive Rat „vergleiche einfach den Hash“ in einem juristischen Umfeld gefährlich. Ein Jurist vergleicht zwei Byte-Hashes, sieht eine Abweichung und schließt fälschlich, das Dokument sei manipuliert worden. In Wirklichkeit hat ein routinemäßiges erneutes Speichern die Hülle verändert, nicht den Inhalt. Ein Entwickler hat dieselbe Falle beim Debuggen von PDF-Hashes dokumentiert (Phoenix Effect), und forensische Gutachter diskutieren sie unter Überschriften wie „Same content different hash values“.
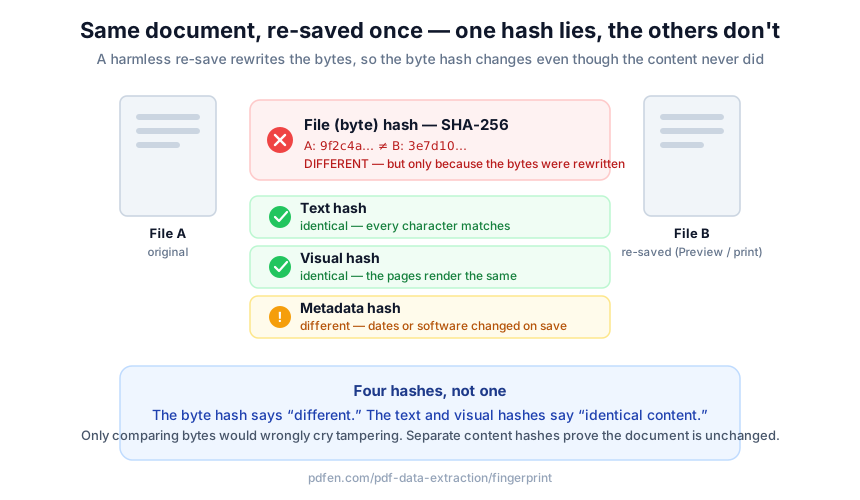 Links: Ein harmloses erneutes Speichern ändert die Rohbytes, sodass der SHA-256-Byte-Hash abweicht (rotes X). Rechts: Die dargestellte Seite und die Textebene sind unverändert, sodass Inhalts-Hash und visueller Hash weiterhin übereinstimmen (grünes Häkchen).
Wie unterscheidest du also eine echte Änderung von einem bloß kosmetischen erneuten Speichern? Indem du dich nicht auf einen einzelnen Byte-Hash verlässt.
Wie prüfst du, ob zwei PDF-Dateien gleich sind, ohne Fehlalarm?
Du hashst die Ebenen getrennt, nicht nur die Rohbytes. Ein Datei-Hash beantwortet die Frage „Sind das exakt dieselben Bytes?“ Ein Inhalts-Hash beantwortet die Frage, die dich meist interessiert: „Ist das dasselbe Dokument?“ Als ich das Fingerabdruck-Tool bei PDFengine gebaut habe, ergab sich dieser Ansatz in Ebenen direkt daraus, dass ich beobachtet habe, wie Leute reine Byte-Abweichungen als Betrug missverstanden.
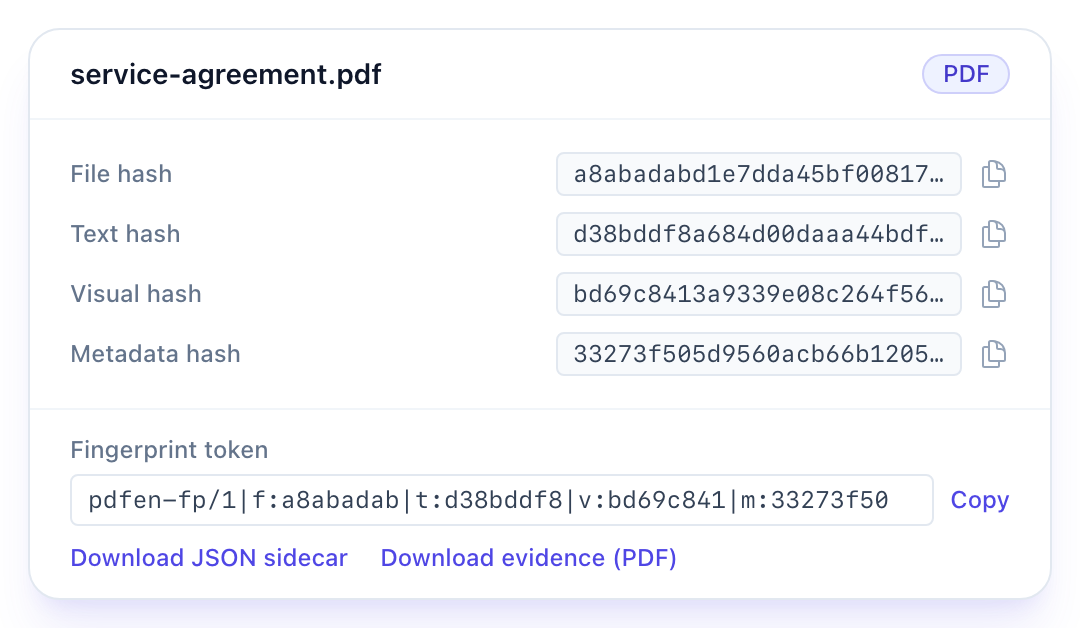
Das PDFengine-Fingerabdruck-Tool berechnet vier getrennte Hashes einer Datei:
Datei-Hash – SHA-256 der Rohbytes. Erkennt jede Änderung überhaupt, auch das Neuschreiben des
/ID-Felds.Text-Hash – die normalisierte Textebene ohne Metadaten. Das ist dein Inhalts-Fingerabdruck.
Visueller Hash – die normalisierten gerenderten Seiten, sodass auch gescannte oder bildbasierte Dokumente abgedeckt sind.
Metadaten-Hash – die normalisierten Metadaten, für sich allein betrachtet.
Weil die Ebenen unabhängig voneinander sind, kannst du etwas beweisen, was eine einfache Prüfsumme nie könnte. Angenommen, du entfernst vor dem Weitergeben personenbezogene Metadaten aus einem Vertrag, etwa mit einem Tool wie Metadaten-Entfernung. Der Datei-Hash ändert sich und der Metadaten-Hash ändert sich, genau wie erwartet. Aber Text-Hash und visueller Hash bleiben identisch. Diese Kombination ist der Beweis: Der Inhalt blieb unberührt, nur die Metadaten haben sich verändert. Ein einzelner Byte-Hash würde nur „anders“ sagen und dir nichts darüber verraten, was sich tatsächlich unterschieden hat.
Das Fazit: PDFengine berechnet pro Datei vier Hashes in Ebenen, sodass sein Urteil zwischen „gleicher Inhalt, andere Metadaten“ und „der Inhalt weicht ab“ unterscheiden kann – eine Unterscheidung, die kein einzelner SHA-256-String ausdrücken kann.
Wie beweist du in der Praxis, dass ein PDF nicht verändert wurde?
Du erstellst den Fingerabdruck der Datei zu einem bekannten guten Zeitpunkt, speicherst ihn und prüfst ihn später erneut. Der Ablauf ist für Leute gedacht, die nie eine Kommandozeile anfassen werden, also die meisten Juristen, Notare und Compliance-Verantwortlichen. Du lädst das PDF, die Office-Datei, das Bild oder die E-Mail hoch und erhältst ein Fingerabdruck-Token plus eine herunterladbare JSON-Begleitdatei. Dieses Token ist deine Ausgangsbasis.
Später fügst du das Token oder die JSON-Datei unter „Mit einem gespeicherten Fingerabdruck vergleichen“ wieder ein, und das Tool sagt dir genau, was sich geändert hat. Die Urteile sind in verständlicher Sprache formuliert, nicht als Wand aus Hex-Zeichen:
Identisch – Bytes, Inhalt und Metadaten stimmen überein.
Gleicher Inhalt und gleiche Metadaten; nur die Bytes unterscheiden sich – der harmlose Fall eines erneuten Speicherns.
Gleicher Inhalt, andere Metadaten – zum Beispiel entfernte oder bearbeitete Metadaten.
Der Inhalt weicht ab – eine echte Änderung am Dokument.
Bei E-Mails erstellt das Tool Fingerabdrücke pro Knoten, das heißt, jeder Anhang erhält seinen eigenen Satz Hashes. Das ist wichtig, wenn sich ein Streit an einem einzelnen PDF in einer weitergeleiteten Nachricht entscheidet. Wenn du zwei Dateien direkt miteinander statt mit einer gespeicherten Ausgangsbasis prüfen willst, zeigt das Dateivergleichs-Tool dieselbe Gleichheitsmatrix nebeneinander.
Eine Grenze sei klar benannt. Zu beweisen, dass eine E-Mail gesendet wurde, ist eine andere Frage, als zu beweisen, dass eine Datei unverändert ist, und stützt sich auf Übertragungssignale wie SPF und DKIM statt auf Datei-Hashing. Das behandle ich getrennt in So beweist du, dass eine E-Mail gesendet wurde. Dieser Beitrag bleibt bei der Identität von Dateien und PDFs.
Warum SHA-256 und nicht MD5 oder SHA-1?
Weil die älteren Algorithmen für Beweise gebrochen sind und SHA-256 der aktuelle US-Bundesstandard ist (NIST-Projekt zu Hashfunktionen). Das ist keine theoretische Vorsicht. SHA-1-Kollisionen sind nachgewiesen, nicht bloß vorhergesagt. Das Open-Source-Projekt sha1collider erzeugt zwei verschiedene PDFs, die denselben SHA-1-Hash haben (nneonneo auf GitHub).
Denk daran, was das vor Gericht bedeutet. Beruht dein Integritätsnachweis auf SHA-1, kann ein Gegner argumentieren, dass ein übereinstimmender Hash nicht mehr garantiert, dass die Dateien übereinstimmen, weil eine Kollision erreichbar ist. Gegen SHA-256 funktioniert dieses Argument nicht. Seine Ausgabe liegt in einem 2^256-Raum, und es wurde keine praktisch nutzbare Kollision erzeugt. Verwende für alles, was du verteidigen musst, SHA-256 und schau nicht zurück.
Ist ein moderner Algorithmus nicht übertrieben für eine interne Dokumentenprüfung? Nicht wirklich. Der Aufwand für die Berechnung von SHA-256 ist vernachlässigbar, und wer jetzt darauf standardisiert, muss ein Archiv später nie neu hashen, wenn der schwächere Algorithmus endlich ein Audit nicht mehr besteht.
Kann Adobe Acrobat nicht einfach sagen, ob zwei PDFs identisch sind?
Nicht direkt, und das überrascht viele. Acrobat hat keine einfache Schaltfläche „Sind diese beiden Dateien byte-identisch?“ mit Hash. Sein Integritätsmechanismus sind zertifikatsbasierte digitale Signaturen: Es hasht das Dokument, verschlüsselt den Digest mit dem Zertifikat des Unterzeichners und hasht beim Öffnen erneut, um Änderungen nach der Signatur zu erkennen (Adobe-Standards für digitale Signaturen). Das ist wirklich stark, aber nur, wenn das Dokument vorab signiert wurde. „Dateien vergleichen“ in Acrobat ist ein visueller und textueller Abgleich, der die Frage „Was hat sich geändert?“ beantwortet, nicht die Frage „Ist das die kryptografisch identische Datei?“
Deine Frage | Adobe Acrobat | PDFengine-Fingerabdruck |
|---|---|---|
Sind diese beiden Dateien Byte für Byte identisch? | Keine eigene Hash-Prüfung | Datei-Hash (SHA-256) |
Hat sich der Inhalt geändert, abgesehen von einem erneuten Speichern? | Abgleich „Dateien vergleichen“ (visuell) | Text- + visueller Hash |
Beweis ohne vorheriges Signieren der Datei? | Nein; setzt eine vorherige digitale Signatur voraus | Ja; Fingerabdruck für jede vorhandene Datei |
Funktioniert bei E-Mails und Anhängen? | Nein | Ja, pro Knoten |
Ohne technische Kenntnisse nutzbar? | Teilweise | Ja, Urteile in verständlicher Sprache |
Acrobat und PDFengine lösen sich überschneidende, aber unterschiedliche Probleme. Hast du das Dokument vorab signiert, ist die Signatur in Acrobat hervorragend. Bekommst du heute eine Datei und sollst sagen, „ist das dieselbe, die wir letztes Jahr eingereicht haben“, brauchst du einen Fingerabdruck, keine Signatur. Adobes eigene Preisseite informiert über das Abonnement, falls du den Signatur-Workflow nutzen möchtest.
Häufig gestellte Fragen
Warum haben zwei PDFs mit demselben Inhalt unterschiedliche Hashwerte?
Weil beim Speichern eines PDFs verborgene Bytes neu geschrieben werden, vor allem der /ID-Wert im Datei-Trailer, auch wenn sich nichts Sichtbares ändert. Zwei inhaltlich identische PDFs liefern dann unterschiedliche SHA-256-Hashes (iText). Das ist normales Verhalten, keine Manipulation. Ein Text- oder visueller Hash ignoriert diese Hülle und bestätigt, dass der Inhalt derselbe ist.
Beweist ein Hash, dass ein Dokument nicht manipuliert wurde?
Ein übereinstimmender Hash belegt, dass zwei Dateien Byte für Byte identisch sind, was ein starker Beleg für Gleichheit und Integrität ist. Aber ein Hash allein beweist nicht, wer eine Datei wann geändert hat. Nach dem Rahmen der US Federal Rules of Evidence stützen Hashes die Authentifizierung (Duke Judicature), am stärksten in Kombination mit einem vertrauenswürdigen Zeitstempel oder einer Signatur. Sie stützen die Zulässigkeit, garantieren sie aber nicht.
Wie bekomme ich den SHA-256 eines PDFs ohne Kommandozeile?
Lade die Datei in das PDFengine-Fingerabdruck-Tool hoch, und du erhältst den SHA-256-Datei-Hash plus drei inhaltsbasierte Hashes, ganz ohne Terminal. Das ist für nicht technische Nutzer wichtig; in Adobe-Foren zeigen Threads, dass Leute ohne jede Kommandozeile prüfen wollen, ob ein Download unverändert ist (Adobe Community). Außerdem erhältst du ein speicherbares Token und ein herunterladbares Beweis-PDF.
Kann ich beweisen, dass das Entfernen von Metadaten den eigentlichen Inhalt nicht verändert hat?
Ja, und genau hier zahlen sich getrennte Hashes aus. Nach dem Entfernen der Metadaten ändern sich der Datei-Hash und der Metadaten-Hash, aber Text-Hash und visueller Hash bleiben identisch. Diese Kombination beweist, dass der Inhalt unberührt blieb. Ein einzelner Byte-Hash kann nur „anders“ sagen, was fälschlich nahelegen würde, das Dokument selbst sei bearbeitet worden, obwohl sich nur die Metadaten geändert haben.
Sollte ich SHA-1 oder MD5 verwenden, wenn unser altes System das nutzt?
Nicht für alles, was du möglicherweise verteidigen musst. SHA-1-Kollisionen sind nachgewiesen: Das Projekt sha1collider erzeugt zwei verschiedene PDFs mit demselben SHA-1-Hash (GitHub). SHA-256 ist der US-Bundesstandard (NIST FIPS 180-4) und hat keine praktisch nutzbare Kollision. Behalte den alten Hash für Legacy-Abfragen, wenn es sein muss, aber stütze Beweise auf SHA-256.
Ein Ergebnis, das du verteidigen kannst
Zu beweisen, dass ein PDF identisch ist oder nicht verändert wurde, ist differenzierter als „vergleiche den Hash“. Der Byte-Hash sagt die Wahrheit, aber nicht die ganze Wahrheit, denn ein gewöhnliches Speichern verändert die Bytes, ohne das Dokument zu berühren. Erst die Trennung von Datei-, Text-, visuellem und Metadaten-Hash macht aus einer verwirrenden Abweichung ein klares Urteil.
Brauchst du diese Klarheit ohne Terminal, erstelle den Fingerabdruck deiner Datei mit dem PDFengine-Fingerabdruck-Tool, speichere das Token und prüfe es erneut, sobald eine Frage aufkommt. Um zwei Dateien gegeneinander abzuwägen, nutze den Dateivergleich. Und denk an die ehrliche Grenze: Ein Hash belegt Gleichheit, nicht Urheberschaft oder Zeitpunkt. Kombiniere ihn dafür mit einem vertrauenswürdigen Zeitstempel oder einer Signatur. So eingesetzt, liefert dir ein Fingerabdruck Belege, hinter denen du stehen kannst.
Von Daan van Tongeren, Gründer von PDFengine.
Ähnliche Artikel
Dateien per E-Mail in PDF umwandeln: Der schnellere Weg
Dateien umwandeln, zusammenführen oder komprimieren ist mit der E-Mail-Konvertierung noch effiziente...
Warum du deinem PDF ein Deckblatt hinzufügen solltest
Ein Deckblatt gibt deinem PDF Struktur und einen professionellen Auftritt. So nutzt du diese praktis...